Superlinked là gì?
Superlinked là một compute framework mã nguồn mở (Apache 2.0) được thiết kế để biến dữ liệu phức tạp thành vector embeddings, phục vụ các hệ thống RAG, semantic search, recommendation systems và analytics.
Dự án được xây dựng bởi đội ngũ tại superlinked.com, dẫn dắt bởi CEO Daniel Svonava và đồng sáng lập Ben Gutkovich, với sự hậu thuẫn từ Index Ventures.
Hành trình từ Superlinked → SIE
Superlinked ban đầu ra đời như một framework Python giúp kết hợp metadata với dữ liệu phi cấu trúc (text, image) thành các vector đa phương thức (multi-modal). Tuy nhiên, đội ngũ nhận ra rằng vấn đề đau đầu nhất trong production chính là inference — chạy embedding models hiệu quả ở scale lớn.
Vì vậy, Superlinked đã pivoted và cho ra đời Superlinked Inference Engine (SIE): một inference server mã nguồn mở chuyên dụng. Repo superlinked/superlinked (43 sao) đã được archive vào tháng 5/2026 và chuyển hướng sang superlinked/sie (2.2k sao).
Bài viết này sẽ tổng quan cả hai: kiến trúc của Superlinked framework và SIE inference engine kế thừa.
Kiến trúc Superlinked Framework (declarative DAG)
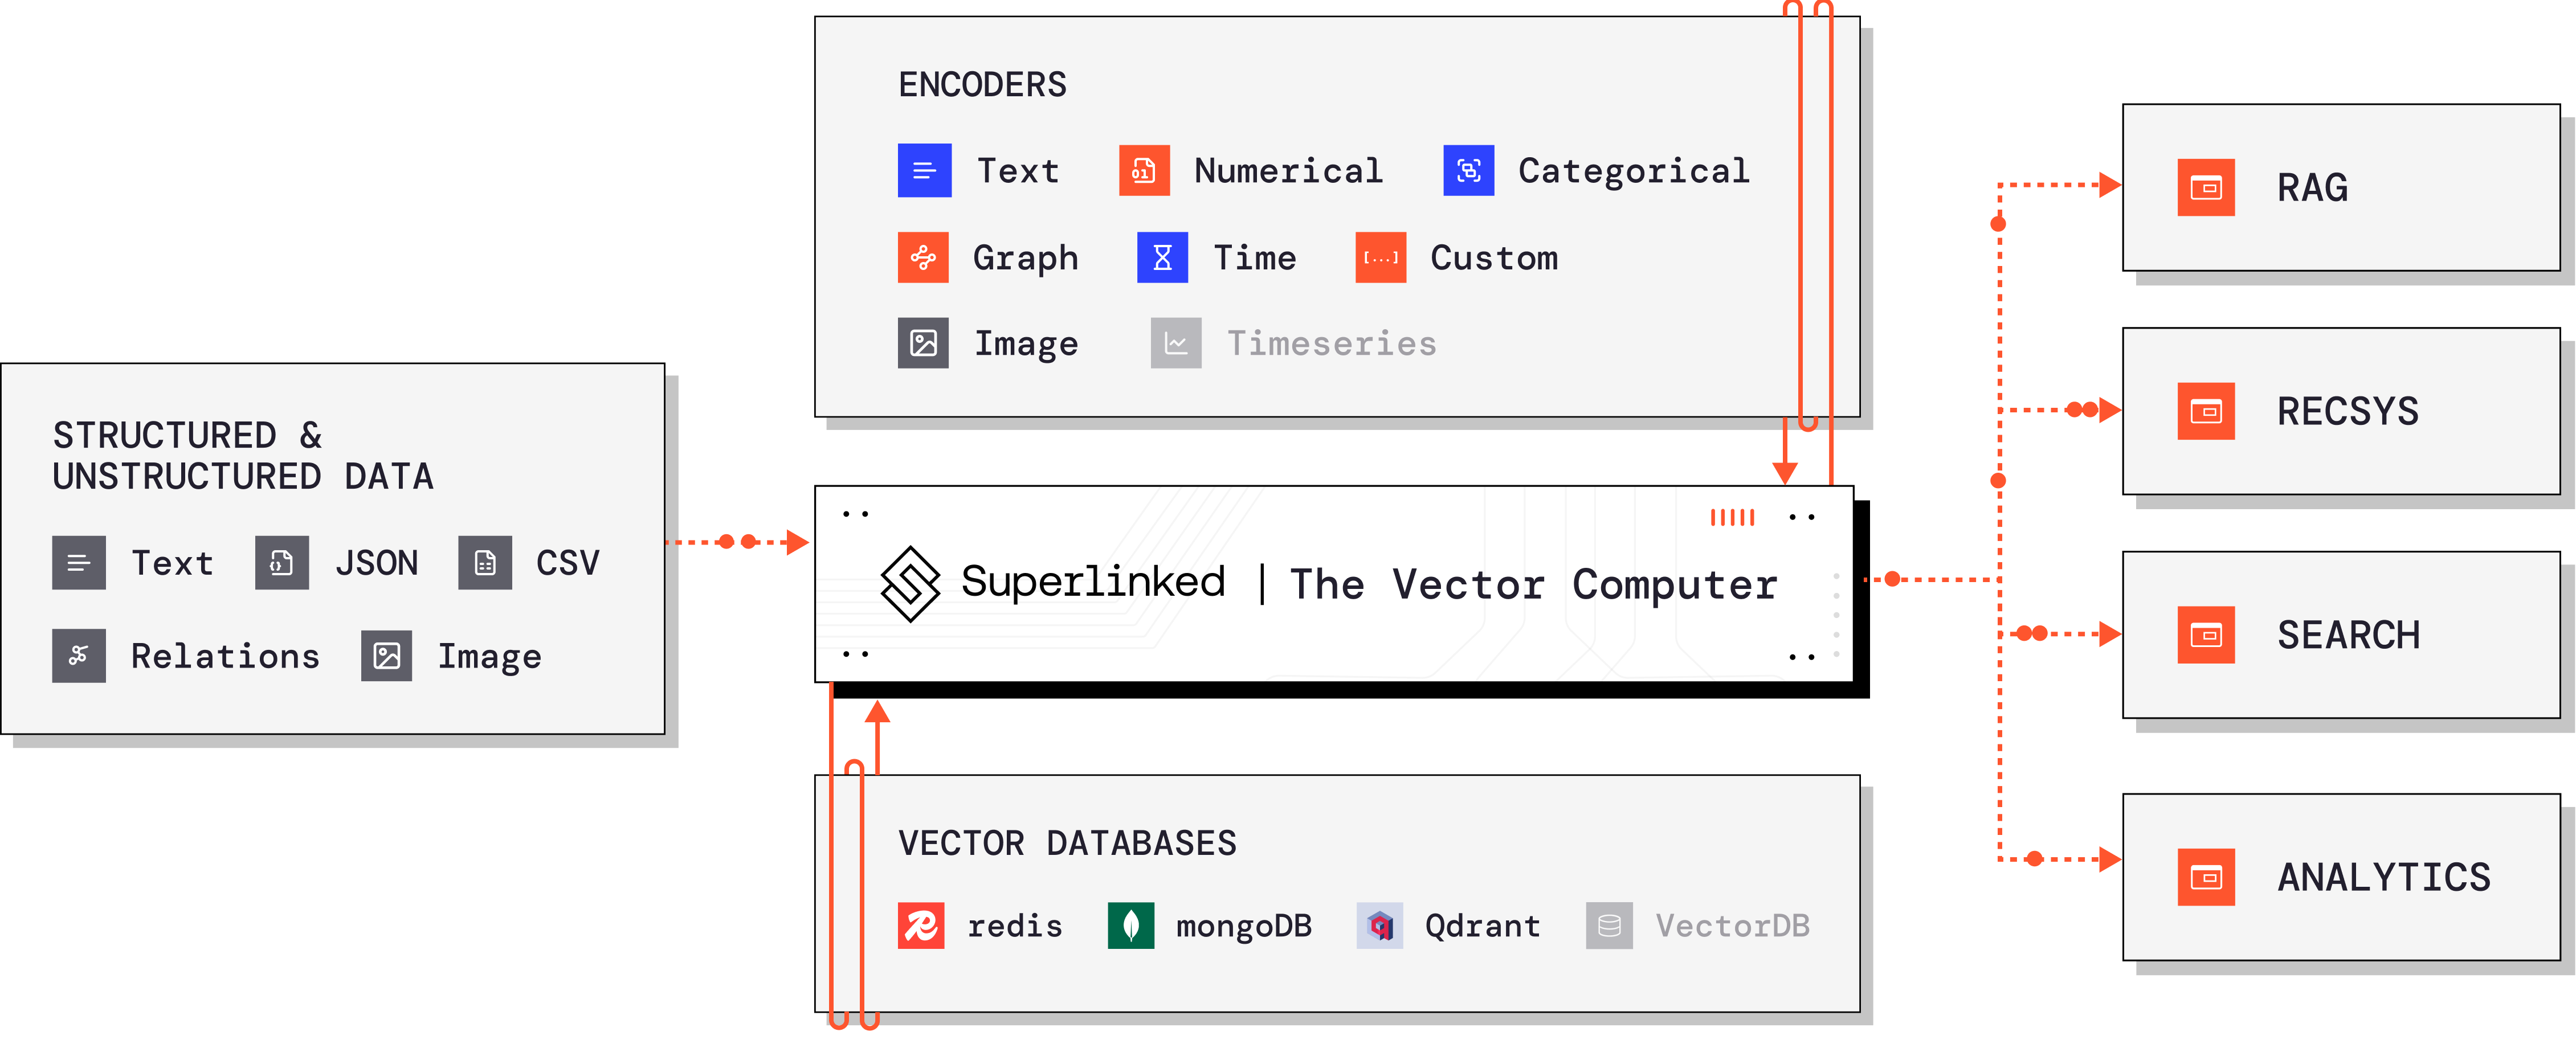
Superlinked framework được xây dựng trên kiến trúc declarative DAG (Directed Acyclic Graph). Bốn khối xây dựng chính:
1. Schema
Khai báo cấu trúc dữ liệu và kiểu field. Hỗ trợ IdField, String, Integer, Float, và các kiểu phức tạp khác.
class Product(sl.Schema):
    id: sl.IdField
    description: sl.String
    rating: sl.Integer
2. Space
Định nghĩa cách một field được biến đổi thành vector. Các loại space:
- TextSimilaritySpace — dùng sentence-transformers để embedding text
- NumberSpace — số (min-max hoặc similarity mode)
- CategoricalSpace — category dạng one-hot hoặc embedding
- RecencySpace — thời gian (gần đây = trọng số cao)
- ImageSpace — dùng OpenCLIP embedding ảnh
description_space = sl.TextSimilaritySpace(
    text=product.description, model="Alibaba-NLP/gte-large-en-v1.5"
)
rating_space = sl.NumberSpace(
    number=product.rating, min_value=1, max_value=5, mode=sl.Mode.MAXIMUM
)
3. Index
Tổng hợp nhiều Space thành một vector duy nhất thông qua ConcatenationNode (nối vector) và AggregationNode (gộp có trọng số). Index quản lý persistence và event-based updates.
index = sl.Index([description_space, rating_space], fields=[product.rating])
4. Query
Định nghĩa logic tìm kiếm: similarity search, hard filtering, dynamic weights, và Natural Language Query (dùng LLM để trích xuất tham số từ câu query tự nhiên).
query = (
    sl.Query(index, weights={
        description_space: sl.Param("description_weight"),
        rating_space: sl.Param("rating_weight"),
    })
    .find(product)
    .similar(description_space, sl.Param("description_query"))
    .limit(sl.Param("limit"))
    .with_natural_query(
        sl.Param("natural_language_query"),
        sl.OpenAIClientConfig(api_key=os.environ["OPEN_AI_API_KEY"], model="gpt-4o")
    )
)
Cơ chế hoạt động
Online Ingestion DAG
Khi dữ liệu được đưa vào qua source.put(data), OnlineSchemaDagCompiler biên dịch DAG thành OnlineSchemaDag, đi qua các node:
- Chunking → Embedding (dùng
SentenceTransformerManagerhoặcModalEngine) → Aggregation → Concatenation → Index → VDB write.
Embedding engine có cơ chế DelayedEvaluator gộp nhiều request để batch inference, tăng throughput khi dùng remote GPU.
Query DAG
Query được compile riêng bởi QueryDagCompiler, bỏ qua các node không cần ở query-time (như ChunkingNode, ComparisonFilterNode). Chỉ giữ lại các node cần cho vector calculation và similarity search.
Từ prototype lên production
Superlinked cung cấp 2 executor:
| Executor | Mục đích | Storage |
|---|---|---|
InMemoryExecutor |
Phát triển, test nhanh | In-memory |
RestExecutor |
Production | Redis, Qdrant, MongoDB, TopK |
Chỉ cần đổi executor, toàn bộ code giữ nguyên — unifying evaluation, ingestion và serving stack.
Superlinked Inference Engine (SIE)
Sự kế thừa của Superlinked, tập trung vào self-hosted inference cho agents. SIE là một inference server/cluster chạy 100+ model qua một API duy nhất, tương thích OpenAI API.
Kiến trúc SIE
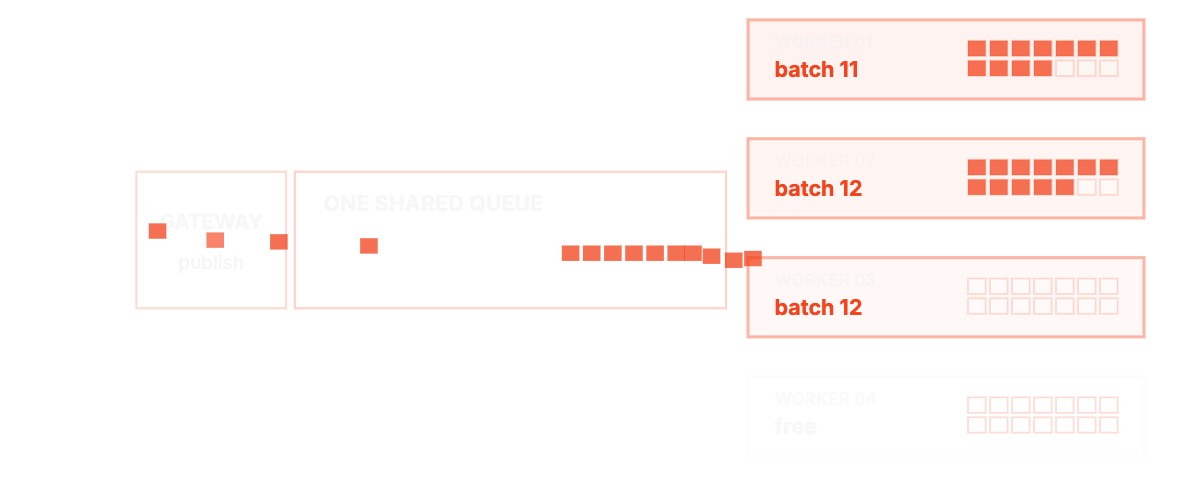
- Gateway load-balancing — phân phối request đến các worker
- KEDA autoscaling — scale-to-zero khi không dùng
- Grafana dashboards — quan sát toàn bộ cluster
- LRU eviction — load/unload model theo nhu cầu
- Hỗ trợ GPU (CUDA) và Apple Silicon (MLX)
Các task SIE hỗ trợ
| Task | Models |
|---|---|
| Search | bge-m3, splade-v3, colbertv2, qwen3-reranker |
| Document → Markdown | glm-ocr, mineru, paddleocr-vl, docling |
| Structured output | gliner2, nuner-zero, qwen3.6-27b |
| Content safety | granite-guardian-2b |
| Agent loop | qwen3.6-27b (open LLM) |
Quickstart SIE
pip install "sie-server[local]" && sie-server serve

# Hoặc Docker với GPU
docker run --gpus all -p 8080:8080 \
  -v sie-hf-cache:/app/.cache/huggingface \
  ghcr.io/superlinked/sie-server:latest-cuda12-default
API tương thích OpenAI:
curl http://localhost:8080/v1/embeddings \
  -H 'Content-Type: application/json' \
  -d '{"model": "sentence-transformers/all-MiniLM-L6-v2", "input": "Hello world"}'
Tích hợp hệ sinh thái
SIE tích hợp sẵn với: LangChain, LlamaIndex, Haystack, DSPy, CrewAI, Chroma, Qdrant, Weaviate, LanceDB.
Cung cấp MCP server cho Claude và các MCP clients: offload document processing (OCR, extraction, summarization) khỏi frontier-model bill.
Superlinked vs LangChain/LlamaIndex
| Tiêu chí | Superlinked | LangChain / LlamaIndex |
|---|---|---|
| Chuyên môn | Vector compute (chunk, embed, search) | General-purpose LLM framework |
| Kiến trúc | Declarative DAG | Chain / Pipeline |
| Dynamic weights | First-class citizen | Cần custom reranker |
| Multi-modal | Text + Image + Number + Category + Time | Chủ yếu text |
| Inference server | SIE (self-hosted, 100+ models) | Phụ thuộc bên thứ ba |
Kết luận
Superlinked (và SIE kế thừa) giải quyết một vấn đề rất thực tế: vector compute và inference cho AI search/agent ở production. Nếu bạn đang xây dựng hệ thống RAG, semantic search, hoặc recommendation cần kết hợp nhiều loại dữ liệu (text, số, thời gian, hình ảnh) thì Superlinked là một lựa chọn đáng cân nhắc — đặc biệt khi query-time weighting là yêu cầu core, không phải workaround.
Với SIE, bạn có thể self-host toàn bộ inference stack (embedding, reranking, OCR, generation) mà không phụ thuộc vào API bên thứ ba, giữ dữ liệu hoàn toàn trong cloud hoặc air-gapped environment của mình.
Links: