
Blog
Practical Insights on Data, AI and Enterprise Technology
 Superlinked — Compute Framework cho Vector Search và AI Inference
 Tech Radar
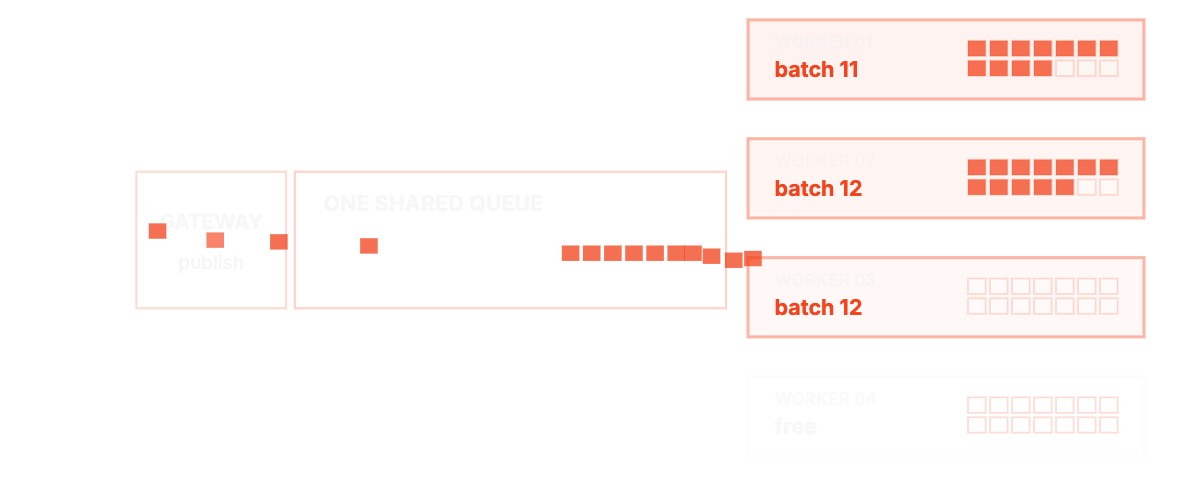
Edge hay Lambda: chia workload theo mô hình tính, đừng chia theo thương hiệu cloud

 Superlinked — Compute Framework cho Vector Search và AI Inference
 Tech Radar
Edge hay Lambda: chia workload theo mô hình tính, đừng chia theo thương hiệu cloud
Tech Radar
Thiết kế nền tảng nội bộ cho 'developer thứ N+1': AI agent là người dùng của platform
 Data & AI
Context engineering cho agent: cửa sổ 1M token không cứu được context bẩn
Chuyên mục
Khám phá nội dung theo chủ đề
AI Agents
 Architecture
 Automation
 Case Studies
 Cloud & Infrastructure
 Data & AI
 Enterprise Integration
 Tech Radar

Architecture
Automation
Case Studies
Cloud & Infrastructure
Data & AI
Enterprise Integration
Tech Radar
Biên tập viên chọn

Mới nhất
Xem tất cả →-
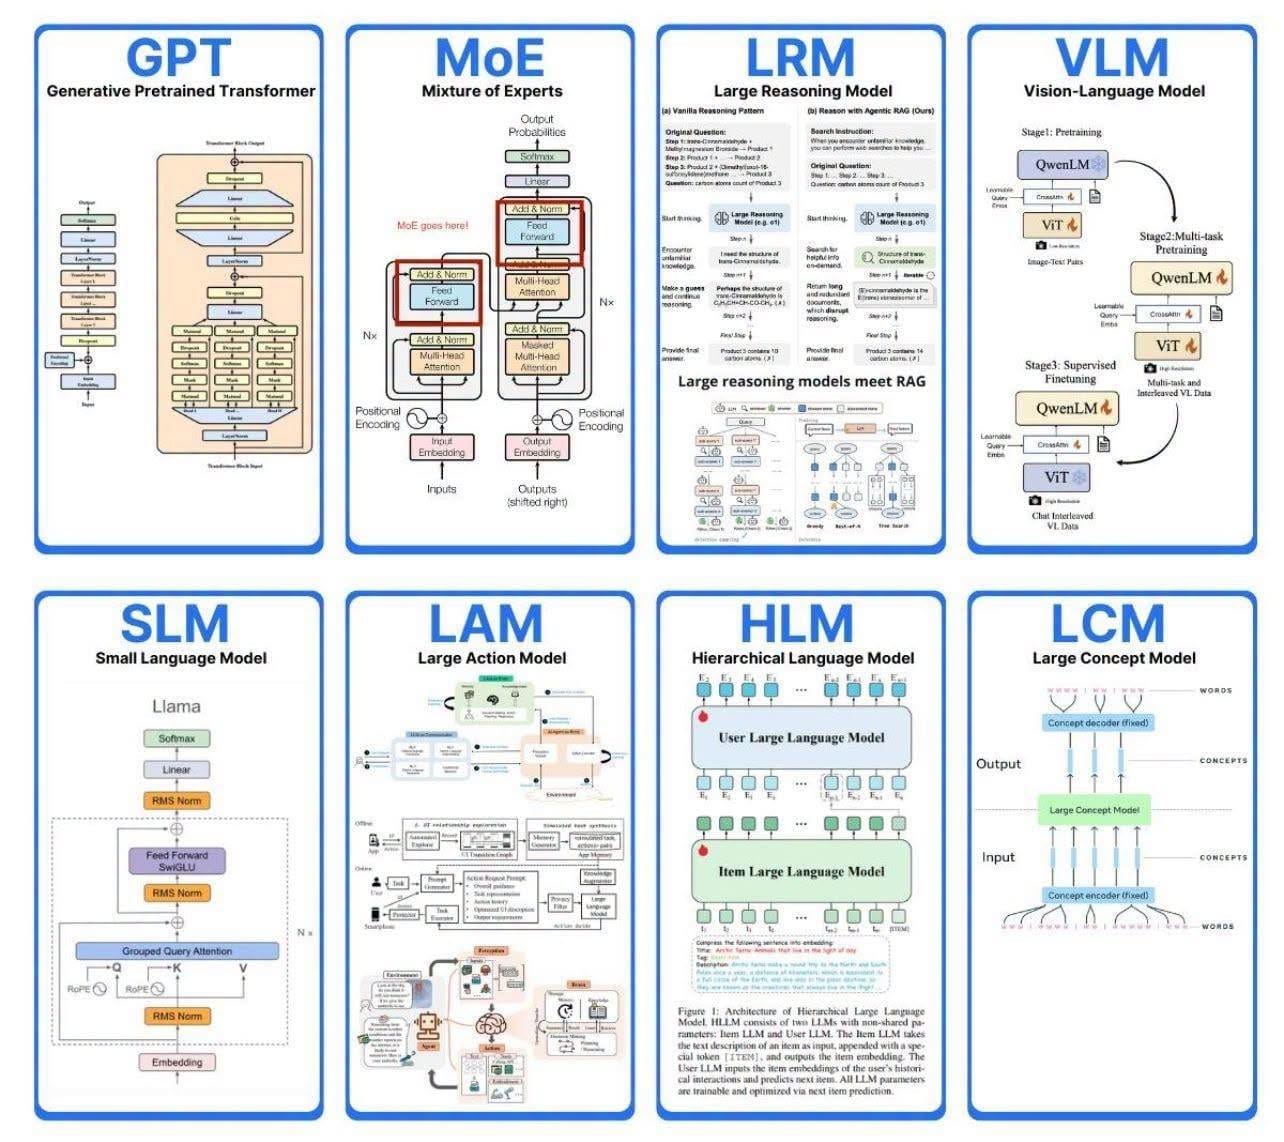
AI hiện đại không chỉ có LLM !
Ngày nay, khi nói về AI, chúng ta thường nói về LLM (Large Language Models). Tuy nhiên, ngoài LLM, chúng ta còn
-
Superlinked — Compute Framework cho Vector Search và AI Inference
Superlinked là gì?
Superlinked là một compute framework mã nguồn mở (Apache 2.0) được thiết kế để biến dữ liệu phức
-
-
-
Context engineering cho agent: cửa sổ 1M token không cứu được context bẩn Model 2026 đua nhau lên 1M context, nhưng hơn 70% lỗi ứng dụng LLM vẫn đến từ context sai và thừa. Quản lý context như quản lý bộ nhớ hệ điều hành — đó mới là kỷ luật cần học.
-
Human-in-the-loop cho AI agent: thiết kế 'sudo prompt' cho quy trình tự động trước hạn EU AI Act HITL không phải checkbox tuân thủ mà là pattern kiến trúc: điểm dừng bắt buộc, có audit, tại ranh giới hành động rủi ro cao — như sudo trong Linux. Còn 2 tuần trước hạn Điều 14 EU AI Act.
-
Kafka bỏ đĩa cứng: KIP-1150 Diskless Topics và bài toán cắt 80% chi phí streaming trên cloud KIP-1150 được chấp nhận 3/2026: Kafka topic ghi thẳng object storage, bỏ replication cross-AZ. Ai nên đổi độ trễ lấy 80% chi phí, ai nên giữ Kafka classic?
-
Spec-Driven Development với GitHub Spec Kit: đặc tả trước, sinh code sau Feature nhiều ngày công mà giao cho coding agent bằng prompt ad-hoc thì sớm muộn cũng thành vibe coding. Spec Kit đưa ra quy trình 4 pha để spec — chứ không phải prompt — là nguồn sự thật.
-
Voicebot dưới 800ms: vì sao độ trễ, không phải giọng nói, quyết định voice AI thành hay bại Giọng TTS đã đủ giống người từ lâu. Thứ khiến khách cúp máy là 1,5 giây im lặng sau mỗi câu hỏi. Mổ xẻ latency budget của một cuộc gọi voicebot và vì sao pipeline STT→LLM→TTS cũ không thể thắng.
-
Thiết kế MCP server cho hệ thống nội bộ: đừng bê nguyên REST API sang Auto-generate MCP server từ OpenAPI spec là con đường ngắn nhất đến một agent đốt token vô ích. REST phục vụ developer, MCP phục vụ LLM — hai đối tượng này cần thiết kế khác nhau.
-
Tetragon thay Falco + auditd: gom runtime security về một agent eBPF Chạy Falco lẫn auditd trên cùng một node là chồng chéo tốn kém. Đánh giá thẳng việc hợp nhất về Tetragon 1.4: enforce inline trong kernel, TracingPolicy thực tế, và chi phí event data ít ai nói.
-
Webhook đạt chuẩn production 2026: Standard Webhooks, JWKS và bài toán replay Webhook 'chạy được' và webhook 'chạy đáng tin' cách nhau một checklist: chuẩn Standard Webhooks, signing key xoay qua JWKS, retry có DLQ và idempotency key phía nhận.
-
Tự host LLM bằng vLLM: bài toán chi phí và checklist trước khi rời API Ở volume ổn định, self-host rẻ hơn API 8–18x mỗi token — nhưng chỉ khi bạn tính đúng công thức break-even và trả nổi cái giá vận hành. Bài toán tài chính + kỹ thuật cho tech lead VN năm 2026.
-
Wasm ra khỏi trình duyệt: khi nào WebAssembly thay container cho microservice nhẹ WASI và Component Model đã chín, cold start 1-5ms, bộ nhớ bằng 1/10 Node.js. Nhưng Wasm server-side chỉ hợp một lớp workload cụ thể — bài này giúp bạn quyết định thí điểm ở đâu.
-
Khi khách hàng là một AI agent: chuẩn bị website và catalog cho agentic commerce trước 2027 AI agent đang đi mua hàng thay người thật — và chúng chọn brand theo chất lượng dữ liệu, không theo banner. Doanh nghiệp Việt bán online cần làm gì về mặt kỹ thuật để không vô hình trước làn sóng này.
-
42% quay về monolith: đọc lại bài toán microservices bằng con mắt chi phí 2026 42% tổ chức đang gộp microservices lại, service mesh rơi từ 18% xuống 8%. Không phải microservices sai — mà là hóa đơn thật đã về. Framework quyết định cho đội 10-50 kỹ sư.
Khách hàng nói gì
Khách hàng nói gì
Khách hàng nói gì
về POPTECH
Phản hồi từ các lãnh đạo công nghệ tại những doanh nghiệp đã triển khai cùng chúng tôi.
“Tận tâm”
POPTECH là một đối tác chuyên nghiệp và giàu kinh nghiệm, luôn đưa ra những góc nhìn và khuyến nghị giá trị — một đối tác thực sự đồng hành để cùng tạo nên thành công.
“Hỗ trợ tuyệt vời”
Các bạn đã làm rất tốt ở nền tảng OpBa AI Banking RoBot & Engagement trong dự án DBS. Cảm ơn đội ngũ vì một công việc xuất sắc.
“Đội ngũ hướng khách hàng”
Nhân sự của POPTECH là những người thông minh và có nền tảng công nghệ rất vững. Họ hướng tới khách hàng và tập trung cao vào mục tiêu kinh doanh.
Hợp tác cùng POPTECH
Bạn có một dự án hướng tới tương lai?
Đưa Data và AI
vào vận hành thực tế
POPTECH đồng hành cùng doanh nghiệp trong việc thiết kế kiến trúc, phát triển giải pháp và triển khai các nền tảng Data, AI, tự động hóa và tích hợp doanh nghiệp.

Năng lực triển khai