Hóa đơn API tháng trước của team bạn: 9.000 USD. Tháng này: 14.000. Sản phẩm đang lên, traffic tăng đều, và CFO bắt đầu hỏi cái câu quen thuộc: "Sao mình không tự chạy model?" Câu hỏi đúng. Nhưng trả lời "mua GPU đi" mà không tính break-even thì sáu tháng sau bạn sẽ ngồi giải trình vì sao cụm H100 chạy 15% utilization.
Đây là bài toán quyết định, không phải bài toán tôn giáo. Có con số thì tính được.
Công thức break-even: đừng đoán, hãy chia
Chi phí self-host mỗi tháng gồm ba khoản:
- GPU: mua đứt (khấu hao 3 năm) hoặc thuê cloud. Một node 8×H100 thuê rơi vào vài chục nghìn USD/tháng tùy nhà cung cấp; mua đứt thì chia đều theo 36 tháng cộng hạ tầng.
- Điện + datacenter: node H100 full load ăn ~10kW. Nhân giá điện công nghiệp, cộng cooling.
- Người: tối thiểu một phần thời gian của 1–2 kỹ sư biết CUDA, biết đọc log vLLM, và chịu on-call.
Bên kia phương trình: throughput thực tế của bạn (token/giây khi batch tốt) nhân ra token/tháng, so với giá $/1M token của API đang dùng.
break_even_tokens/tháng = chi_phí_self_host_tháng / giá_API_per_token

Ví dụ: node tốn $25.000/tháng (GPU + điện + 0.5 FTE),
API blended $2/1M token
→ hòa vốn tại 12.5 tỷ token/tháng ≈ 420M token/ngày
Nghe nhiều, nhưng một sản phẩm B2B có vài chục nghìn user active với RAG pipeline chạy nền dễ dàng chạm mức đó. Điểm mấu chốt: con số 8–18x rẻ hơn mỗi token chỉ đúng khi volume ổn định và utilization cao. GPU idle là tiền đốt. Nếu traffic của bạn spike theo giờ hành chính rồi chết ban đêm, hiệu số co lại nhanh. Các tổ chức làm đúng bài này thường giảm được 60–80% chi phí mỗi request — nhưng "làm đúng" là mệnh đề có điều kiện.
Và năm 2026 ở Việt Nam có thêm một biến không nằm trong spreadsheet: Luật 134/2025 hiệu lực từ 3/2026, các ngành rủi ro cao có lộ trình đến 2027. Với ngân hàng, y tế, dữ liệu công dân — câu hỏi không còn là "rẻ hơn bao nhiêu" mà là "dữ liệu có được rời lãnh thổ không". On-prem hoặc GPU cloud nội địa (FPT AI Factory đang chạy hàng nghìn H100 từ dự án $200M với NVIDIA) chuyển từ lựa chọn tiết kiệm sang yêu cầu tuân thủ.
vLLM là mặc định, và migration gần như miễn phí
Giữa 2026, chọn serving engine không còn là cuộc tranh luận. vLLM thắng vì ba thứ:
- PagedAttention: quản lý KV cache như OS quản lý virtual memory, hết cảnh phí VRAM vì fragmentation.
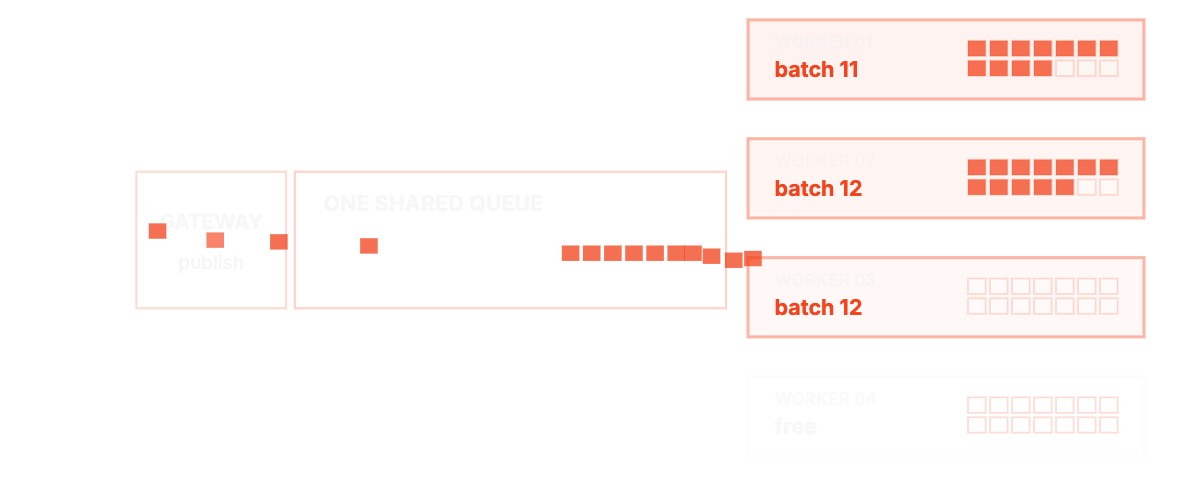
- Continuous batching: request mới nhảy vào batch đang chạy thay vì xếp hàng chờ batch cũ xong — throughput gấp 2–3 lần static batching.
- Prefix caching: system prompt dài, few-shot examples lặp lại — tính một lần, dùng mãi. Với RAG pipeline có prompt template cố định, đây là tiền thật.
Quan trọng nhất cho việc migration: vLLM expose OpenAI-compatible API. Code client đổi đúng một dòng:
client = OpenAI(
    base_url="http://llm.internal:8000/v1",  # đổi mỗi dòng này
    api_key="dummy",
)
resp = client.chat.completions.create(
    model="Qwen/Qwen3-32B", messages=messages
)
Nghĩa là bạn có thể chạy song song: 10% traffic sang cụm tự host, đo chất lượng và latency, rồi mới quyết. Không có big-bang migration.
Model đáng chạy giữa 2026: Qwen 3.x (MoE, mạnh tiếng Việt bất ngờ), DeepSeek V4, Llama 4, Gemma cho tác vụ nhẹ. Open-weight không còn là "bản kém của frontier" — cho tác vụ hẹp, model nhỏ fine-tune bằng QLoRA có thể chính xác hơn API frontier mà rẻ hơn hàng chục lần.
Ba đòn bẩy ép chi phí sau khi đã tự host
Break-even chỉ là điểm bắt đầu. Ba đòn bẩy sau quyết định bạn tiết kiệm 2x hay 10x:
| Đòn bẩy | Được gì | Trả giá gì |
|---|---|---|
| FP8 trên H100 | 1.3–2x throughput | <2% chất lượng, gần như không đo được ở tác vụ thường |
| KV cache INT8/INT4 | Lấy lại 30–50% VRAM → batch to hơn, context dài hơn | Cần eval kỹ với context rất dài |
| Model nhỏ + fine-tune | 7B–32B thay vì 70B+, chi phí giảm theo bậc | Phải có eval set và pipeline fine-tune (Unsloth làm QLoRA gần như một lệnh) |
Thứ tự làm: FP8 trước (gần như free lunch), KV cache quantization khi VRAM là nút thắt, fine-tune model nhỏ khi bạn đã có dữ liệu và eval set tử tế.
Một cửa thoát nữa mới mở: ROCm. Từ 1/2026, AMD pass ~93% test suite của vLLM — nghĩa là MI300X không còn là canh bạc. Khi H100 khan hàng hoặc bị hét giá, có phương án B là có sức mặc cả. Thế độc quyền NVIDIA lần đầu tiên có vết nứt thật ở tầng serving.
Cái giá không nằm trên hóa đơn
Đây là phần người ta hay bỏ qua khi hào hứng với con số 8–18x. Rời API nghĩa là bạn nhận về:
- On-call. Model server sập 2 giờ sáng là việc của team bạn, không phải của Anthropic hay OpenAI.
- Vá bảo mật. vLLM, driver, CUDA/ROCm, model weights — tất cả là attack surface bạn phải theo dõi. Prompt injection vẫn là LLM01 của OWASP, và giờ tầng infra cũng thuộc trách nhiệm của bạn.
- Capacity planning. API co giãn vô hạn; cụm GPU của bạn thì không. Traffic tăng 3x sau một chiến dịch marketing là sự cố, không phải tin vui.
- Đuổi theo model mới. API cho bạn model tốt nhất mỗi quý mà không tốn công. Tự host thì mỗi lần đổi model là một chu kỳ benchmark, quantize, canary lại từ đầu.
Nên ở lại API khi: volume dưới điểm hòa vốn vài lần; traffic thất thường; team dưới 5 kỹ sư backend và không ai từng vận hành GPU; tác vụ cần frontier reasoning thật sự; và không có ràng buộc pháp lý về dữ liệu.
Nên đi khi: token volume ổn định trên break-even, có ít nhất một người sống được với nvidia-smi và log vLLM, và — với nhiều ngành ở VN từ 3/2026 — khi luật không cho bạn lựa chọn khác.
Checklist trước khi ký lệnh mua GPU
- Đo token volume thực tế 3 tháng gần nhất, tách prefill/decode. Có tăng trưởng ổn định không, hay spike theo mùa?
- Tính break-even với giá GPU thuê trước — đừng mua đứt khi chưa chạy production 6 tháng.
- Benchmark model open-weight trên eval set của chính bạn, không tin leaderboard.
- Chạy shadow traffic 10–20% qua vLLM ít nhất một tháng, so p95 latency và chất lượng.
- Trả lời được: ai on-call, ai vá CVE, ai làm capacity planning — bằng tên người cụ thể.
- Kiểm tra ràng buộc Luật 134/2025 với loại dữ liệu bạn xử lý; nếu on-prem không khả thi, đánh giá GPU cloud nội địa.
- Có kế hoạch quay lại API nếu thất bại — vì API OpenAI-compatible, đường lui rẻ, nhưng phải viết ra trước.
Điều số 5 đánh trượt nhiều team hơn tất cả các điều còn lại cộng lại.
Tự host năm 2026 không còn khó về kỹ thuật — vLLM đã lo phần đó. Nó khó ở chỗ nó là một cam kết vận hành đội lốt quyết định mua sắm. Team nào tính được cả hai vế thì tiết kiệm thật; team nào chỉ nhìn con số 8–18x thì đang mua cho mình một hệ thống production thứ hai để nuôi.